OpenAI Reduz Contexto do Codex de 372k para 272k — E Isso É Bom
A OpenAI reduziu o contexto do Codex de 372k para 272k tokens. À primeira vista parece um downgrade. Mas contexto maior nem sempre é melhor.
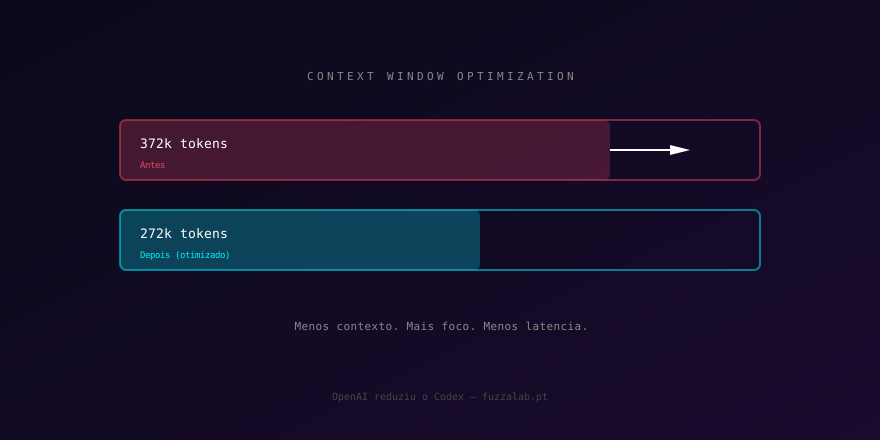
Quando vi o título no Hacker News — "OpenAI reduces Codex Model Context Size from 372k to 272k" — a minha primeira reação foi estranheza. 282 pontos, 136 comentários, e um PR no GitHub que parecia ser um backport menor de metadados. O que é que eu estava a perder?
O commit é simples: um backport (versão 0.144.6) para a linha release/0.144 que atualiza metadados do modelo GPT-5.6, incluindo o tamanho da janela de contexto. Nada de código novo. Apenas um número que desceu: de 372k para 272k tokens.
Há uma explicação mais prosaica do que o «downgrade»: o preço. A documentação da OpenAI cobra o dobro no input e 1,5x no output, durante toda a sessão, para prompts com mais de 272 mil tokens de input. A janela do modelo (cerca de 1,05 milhões) não mudou; mudou o limite que o Codex CLI usa por omissão, o que impede que sessões normais cruzem sem aviso para a faixa premium. Dito isto, os relatos divergem sobre se isto foi só uma correção de metadados ou um corte de uso, e artigos posteriores falam de contexto completo reativado para algumas contas.
Contrariando o dogma de que contexto maior é sempre melhor, contexto grande tem custos reais: latência que escala linearmente, custos de input tokens, e atenção diluída do modelo. Quanto mais tokens, mais ruído o modelo tem de filtrar.
O trade-off que faz sentido
O Codex não é um chatbot de uso geral. É um agente que trabalha sobre bases de código. O contexto de 272k tokens permite incluir o conteúdo relevante do repositório sem arrastar ruído de dependências ou logs.
A decisão da OpenAI alinha-se com investigação recente que mostra que o desempenho em tarefas específicas pode degradar-se quando o contexto ultrapassa um certo limiar.
Recursos adicionais
Partilhar
Comentários 0
Ainda sem comentários — sê o primeiro.