Abliteration e modelos sem censura: do «não» apagado ao WhiteRabbitNeo
A abliteration remove as recusas de um LLM apagando uma única direção nas suas ativações, sem o voltar a treinar. Como funciona, o que custa, para que serve, e o WhiteRabbitNeo (agora Deep Hat), um modelo de cibersegurança treinado para não recusar.
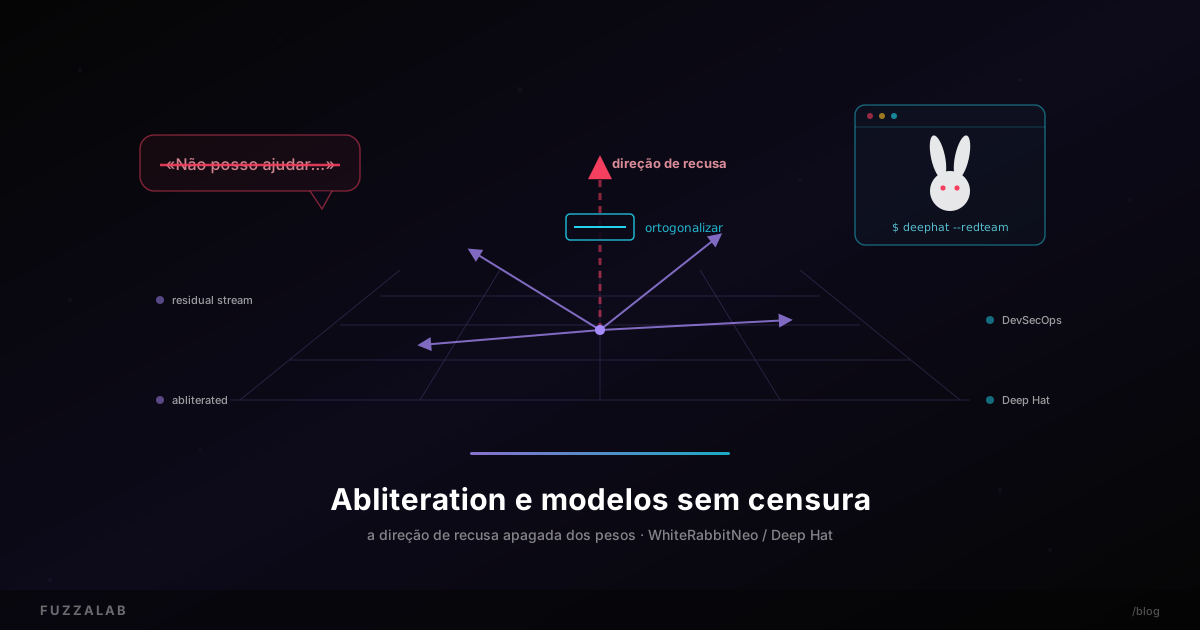
A recusa de um modelo de linguagem não está espalhada por milhares de regras escondidas. Está, em boa parte, numa única direção dentro da sua geometria interna, e essa direção pode ser apagada.
Quem corre modelos locais já se cruzou com nomes como Llama-3-8B-Instruct-abliterated ou Qwen-abliterated no Hugging Face. O sufixo refere-se a uma técnica chamada abliteration (junção de ablation e obliterate), que remove o comportamento de recusa de um LLM sem o voltar a treinar. Ao lado disto existe outra família de modelos “sem censura”, construída de forma diferente e com um propósito muito concreto: a cibersegurança. O exemplo mais conhecido é o WhiteRabbitNeo, hoje chamado Deep Hat.
Este post explica as duas coisas sem código. Para a parte prática, os artigos de referência estão no fim.
Porque é que um modelo recusa
Um modelo base, acabado de sair do pré-treino, não recusa nada: limita-se a continuar texto. As recusas (“Não posso ajudar com isso”) aparecem depois, no fine-tuning de instruções e no alinhamento por preferências humanas. O fabricante mostra ao modelo milhares de exemplos de pedidos que deve declinar, e o modelo aprende a reconhecê-los.
A pergunta interessante é onde fica guardado esse comportamento. Em 2024, Andy Arditi e colegas publicaram o artigo “Refusal in Language Models Is Mediated by a Single Direction”, apresentado na NeurIPS desse ano. A conclusão é surpreendentemente simples: em 13 modelos abertos testados, a decisão de recusar corresponde a uma única direção no espaço de ativações do modelo.
Como funciona a abliteration
Dentro de um transformer, a informação circula por um canal chamado residual stream: cada camada lê desse canal, faz o seu cálculo e escreve lá o resultado. Cada token é representado aí como um vetor com milhares de dimensões. A ideia da abliteration é encontrar, nesse espaço, o eixo que significa “isto é para recusar” e anulá-lo.
O processo tem três fases:
- Recolha. Passam-se pelo modelo dois conjuntos de instruções: um de pedidos nocivos e outro de pedidos inofensivos. No tutorial de Maxime Labonne são algumas centenas de exemplos de cada. Em cada camada, regista-se a ativação do residual stream no último token de cada instrução.
- Diferença de médias. Calcula-se a média das ativações para os pedidos nocivos e para os inofensivos. A diferença entre as duas, normalizada, é a candidata a “direção de recusa” dessa camada.
- Escolha. Há uma candidata por camada, e nem todas funcionam. Testam-se as melhores e escolhe-se a que elimina as recusas sem estragar as respostas. No exemplo do tutorial, a vencedora foi a da camada 9, escolhida por inspeção humana das respostas.
Encontrada a direção, há duas formas de a remover:
- Intervenção em tempo de inferência: enquanto o modelo gera texto, subtrai-se em cada camada a componente das ativações que aponta nessa direção. O modelo original fica intacto, mas é preciso um hook a correr sempre.
- Ortogonalização dos pesos: alteram-se de vez as matrizes que escrevem no residual stream, de modo a que fiquem incapazes de produzir qualquer componente na direção de recusa. O resultado é um modelo novo, com a mesma arquitetura, que se distribui e corre como qualquer outro. É esta a versão que dá origem aos ficheiros “abliterated” no Hugging Face.
Uma analogia útil: imagina uma mesa de mistura com milhares de faders. O alinhamento não acrescentou um aparelho novo à mesa, apenas aprendeu a subir um fader específico quando ouve certos pedidos. A abliteration descobre qual é esse fader e solda-o na posição zero.
O preço a pagar
A operação não sai de graça. No tutorial, o modelo usado (Daredevil-8B, uma fusão de modelos baseada no Llama 3 8B) deixou de recusar, mas piorou em todos os benchmarks avaliados. A direção de recusa não é perfeitamente isolada e arrasta consigo um pouco de outras capacidades.
Para recuperar, o autor fez um curto treino de preferências (DPO) por cima do modelo abliterado, num conjunto de dados genérico: cerca de 6 horas e 45 minutos em 6 GPUs A6000. O resultado, o NeuralDaredevil-8B-abliterated, recuperou quase todo o desempenho perdido, com uma exceção: o GSM8K (problemas de matemática) não voltou ao nível original, porque o conjunto de dados de recuperação quase não tinha matemática.
Os efeitos colaterais típicos, segundo a DeAI, são três: o modelo torna-se demasiado complacente, segue pior as instruções ou perde coerência em entradas fora do comum. Depende muito de quem fez a abliteration e de quão agressiva foi.
“Abliterated” e “uncensored” não são sinónimos
O artigo da DeAI faz uma distinção útil. Debaixo do rótulo “uncensored” cabem três coisas diferentes:
- Fine-tunes com dados sem recusas, como a série Dolphin. O modelo é treinado com um conjunto de exemplos onde responde a tudo. Custa uma execução de treino real e herda os vieses do conjunto de dados.
- Modelos abliterated, como os descritos acima. Edita-se diretamente os pesos, com poucos dados e pouca computação, e não se acrescenta conhecimento nenhum: apenas se retira um comportamento.
- Modelos conduzidos por system prompt, onde a permissividade vem das instruções de sistema e desaparece se a plataforma as substituir.
Também convém não confundir com jailbreak. Um jailbreak é um truque de conversa que engana o modelo num pedido concreto. A abliteration muda o próprio ficheiro do modelo, de forma permanente. E as duas abordagens combinam-se: muitos modelos populares são fine-tunes que depois passam por abliteration.
Há ainda um ponto prático importante: a direção de recusa é específica de cada modelo. Não existe um “patch” universal; cada checkpoint tem de ser processado à parte.
Como se usa na prática
Há dois caminhos:
- Usar um modelo já processado. É o que a maioria faz. Procura-se no Hugging Face o modelo pretendido com o sufixo
abliteratede corre-se como qualquer outro, no Ollama, no LM Studio, no llama.cpp ou no vLLM. Não há nada de especial na execução. - Fazer a abliteration. O tutorial de Labonne usa a biblioteca TransformerLens e segue o código de FailSpy, quem cunhou o termo e publicou as primeiras séries de modelos abliterados. Entretanto apareceram ferramentas que automatizam a escolha de parâmetros, como o Heretic (AGPL-3.0), que procura a combinação que minimiza ao mesmo tempo a taxa de recusas e o afastamento em relação ao modelo original.
Antes de adotar um destes modelos, a DeAI sugere uma verificação em duas frentes: a capacidade (os benchmarks habituais e testes com as tuas próprias tarefas) e o comportamento de recusa, medindo tanto o que o modelo agora aceita como as recusas falsas em pedidos inofensivos que ainda mantém. E a licença do modelo base continua a aplicar-se ao derivado: as políticas de uso do Llama, por exemplo, valem para qualquer versão abliterated.
Para que serve
A abliteration tem usos legítimos claros:
- Investigação em interpretabilidade e alinhamento: é uma demonstração direta de quão frágil é o ajuste de segurança de um modelo aberto, e isso interessa a quem estuda como o tornar mais robusto.
- Red teaming e segurança ofensiva autorizada: um pentester que pede a análise de um exploit conhecido não quer um sermão.
- Áreas com muitas recusas falsas: medicina, direito, jornalismo e ficção com temas difíceis esbarram com frequência em modelos que recusam por excesso de zelo.
O reverso é óbvio. Um modelo abliterado não distingue entre o pentester e quem não tem autorização nenhuma. A DeAI resume bem o risco de pôr um destes modelos num produto sem uma camada de política própria: é “an incident waiting for a prompt”. A responsabilidade passa toda para quem o usa e para quem o integra.
WhiteRabbitNeo, agora Deep Hat: um modelo de segurança sem recusas
O WhiteRabbitNeo é um bom exemplo do primeiro tipo de modelo “uncensored”: não foi abliterado, foi treinado de raiz para responder a perguntas de segurança ofensiva e defensiva. A família nasceu em dezembro de 2023 como projeto aberto, com modelos de 7B, 13B e 33B parâmetros e versões posteriores sobre o Llama 3 e o Llama 3.1, todas publicadas no Hugging Face.
O que trouxe a V3
A versão 3 foi apresentada pela Kindo, a empresa por trás do projeto, em 15 de maio de 2025. As características principais, segundo o anúncio:
- Modelo de 7B parâmetros com pesos abertos, construído sobre o Qwen 2.5 Coder, o que o torna leve o suficiente para correr num portátil potente.
- Treino com mais de um milhão de pares pergunta-resposta baseados em incidentes reais, cobrindo segurança web, malware, infraestrutura como código (IaC), análise de contentores, indicadores de compromisso e bases de dados de vulnerabilidades.
- “Taxonomy-informed fine-tuning”: o treino segue uma taxonomia de tarefas de segurança e progride das mais simples para as mais complexas.
- Uso de ferramentas e tarefas em vários passos, para funcionar como motor de agentes e não apenas como chat.
- Contextos longos, úteis para colar logs extensos ou relatórios inteiros.
A Kindo descreve-o como “uncensored, offensively and defensively”. A filosofia está numa frase do anúncio: se a tua postura de segurança não é puramente defensiva, a tua IA também não deve ser.
Para que serve
Os casos de uso apresentados dividem-se em três áreas:
- Defesa: interpretar logs e relatórios de vulnerabilidades, apoiar a resposta a incidentes e a análise de malware, sugerir correções.
- DevSecOps: rever configurações de infraestrutura como código (por exemplo, planos Terraform com permissões a mais ou recursos expostos) e gerar o código que corrige o problema.
- Ofensiva autorizada: preparar provas de conceito para CVEs recentes e simular cenários de ataque em exercícios de red team.
É aqui que se percebe o interesse de um modelo sem recusas. Um modelo generalista pode bloquear-se a meio de uma análise legítima porque a palavra “exploit” aparece no pedido. Um modelo especializado responde, e conhece o vocabulário da área.
Sobre o desempenho, os números merecem leitura cuidada. A Kindo diz que a V3 resolve 5% dos desafios do Cybench (um benchmark de desafios CTF), igualando ou superando o Llama 3 70B, um modelo dez vezes maior, numa única GPU A100. É um bom resultado para o tamanho, mas 5% continua a ser pouco em termos absolutos, e os números são da própria empresa.
De WhiteRabbitNeo a Deep Hat
Quem procurar hoje a “V3” no Hugging Face encontra uma surpresa: a coleção WhiteRabbitNeo-V3 contém um único modelo, o DeepHat-V1-7B, de agosto de 2025. Não é engano. O site whiterabbitneo.com redireciona agora para deephat.ai, que se apresenta como “Deep Hat, formerly Whiterabbitneo”. Ou seja, a V3 continuou a ser publicada, mas com outro nome.
A mudança não foi só de marca. O Deep Hat atual (V2) tem 30B parâmetros com arquitetura Mixture of Experts e é proprietário, a correr dentro da plataforma Kindo. Os modelos abertos antigos continuam disponíveis no Hugging Face, mas a linha principal deixou de ser aberta.
Como se usa
Há essencialmente três formas de o usar, em outubro de 2026:
- No browser: o site do Deep Hat tem uma opção de uso gratuito em
app.deephat.ai. É o caminho mais rápido para experimentar, com a contrapartida óbvia de que os pedidos passam pelos servidores da Kindo. Não é sítio para colar logs de um cliente. - Na plataforma Kindo: para equipas, o modelo serve de motor a agentes de IA ligados às ferramentas da organização (consolas de nuvem, scanners, repositórios). A Kindo também oferece instalação on-premises, sem chamadas externas, mediante contacto comercial.
- Localmente, com os pesos abertos: o DeepHat-V1-7B pode ser descarregado do Hugging Face e corrido com as ferramentas habituais (Ollama ou LM Studio com uma das quantizações publicadas pela comunidade, vLLM ou SGLang para servir uma API compatível com a da OpenAI, ou o Docker Model Runner). Em BF16 o modelo ocupa cerca de 15 GB; quantizado a 4 bits fica perto de um terço disso, o que cabe num Mac com Apple Silicon ou numa GPU de gama média. O contexto nativo é de 32K tokens e pode ser estendido até 128K com YaRN, à custa de mais memória.
A opção local é a que faz mais sentido em segurança: os dados não saem da máquina e funciona em ambientes isolados da rede. Em qualquer dos casos, trata as respostas como um colega júnior rápido e bem informado: útil para acelerar, mas a precisar de revisão, sobretudo em código de exploit e em correções que vão para produção.
Licença: aberta, com condições
Os pesos abertos estão sob “Apache-2.0 + DeepHat Extended Version”. A base é a Apache 2.0, mas o texto adicional proíbe, entre outros, o uso militar, a criação de desinformação para prejudicar terceiros, a geração de dados pessoais sem autorização, o assédio e as decisões automáticas que afetem direitos legais de pessoas. O modelo é fornecido “as is” e quem o usa assume toda a responsabilidade pelo resultado. Um modelo sem recusas técnicas não é um modelo sem regras.
Conclusão
A abliteration mostrou algo desconfortável sobre os modelos abertos: o ajuste de segurança é uma camada fina, e basta encontrar uma direção num espaço de milhares de dimensões para a desligar. Com algumas centenas de exemplos e uma GPU, qualquer pessoa remove as recusas de um modelo publicado, e paga por isso com alguma perda de qualidade que se recupera em parte com um treino curto.
O WhiteRabbitNeo chegou ao mesmo destino por outro caminho, treinando um modelo especializado que nunca aprendeu a recusar perguntas de segurança. A sua história também mostra para onde o mercado está a ir: começou aberto, ganhou nome na comunidade e a versão mais capaz passou a ser um produto fechado.
Em ambos os casos, a questão não é técnica. Um modelo que responde a tudo é uma ferramenta poderosa nas mãos de quem tem autorização para a usar, e a responsabilidade pelo que se faz com ela fica inteira do lado de quem carrega no Enter.
Recursos adicionais
- Maxime Labonne (Hugging Face) — Uncensor any LLM with abliteration
- DeAI — Abliterated and Uncensored AI Models, Explained
- Arditi et al. — Refusal in Language Models Is Mediated by a Single Direction
- Heretic — abliteration automática
- Kindo — Introducing WhiteRabbitNeo V3
- Hugging Face — DeepHat-V1-7B (pesos abertos e licença)
- Deep Hat (antigo WhiteRabbitNeo)
Partilhar
Comentários 0
Ainda sem comentários — sê o primeiro.